01 认识 AI 与 LLM
- AI、LLM、多模态与模型应用
- Prompt、Token、上下文与幻觉
- 判断适用任务,知道何时要核查
你能带走一份自己的 AI 任务清单
写邮件、做报表、整理资料,哪一步可以交给 AI?
工具的名字很熟,真要自己上手,却不知道从哪里开始。
视频看懂了,也收藏了,换成自己的任务就卡住了。
今天,先让 AI 帮你完成一件真实的工作。
从会用 AI,到让 AI 按你的方式工作。
说清目标、补充背景、持续追问,把 AI 用进日常工作。
判断什么适合交给 AI,什么容易出错,哪些结果需要核查。
借助程序员使用的 Harness 工程,把 AI 接进自己的工作流程。
用 Skills 复用做事方法,用任务编排组织步骤,让 AI 按流程干活。
能使用 SOTA 模型,结合自己的任务,比较效果、速度与成本。
学会海外 AI 服务的订阅与支付,管好续费、额度和使用预算。
从理解 AI,到拥有自己的工作 Agent。
AI / LLM · 能力边界
一份任务清单
提问 · 追问 · 核查
一份工作草稿
文件 · 工具 · 计划
一个本地交付物
跑通 · 提炼 · 复用
一个自己的 Skill
拆任务 · 串工具 · 验收
一条完整工作流
SOTA · API · 订阅
模型选择与预算
贯穿练习:把零散资料,做成一份可核查、可重复产出的工作报告。
第 1 至 3 阶段 · 基础入门
你能带走一份自己的 AI 任务清单
你能带走一份经过核查的工作草稿
你能带走一份本地报告和一套工作规则
第 4 至 6 阶段 · 工作流进阶
你能带走一个能复用的个人 Skill
你能带走一条附来源、可复跑的调研工作流
你能带走适合自己的模型与订阅方案
AI 的来路 · 1950 → 2022
一条主线:让人写规则,逐渐走向让机器从数据中学习。
用 Imitation Game
讨论机器智能
AI 研究的标志性起点
提案写于 1955 年
通过调整权重
从样本学习分类
把专家经验
写进规则库
代表性论文推动
多层网络训练
搜索与局面评估
击败国际象棋冠军
数据 + GPU + 深层网络
推进图像识别
网络 + 搜索 + RL
战胜李世石
Attention Is
All You Need
先做语言 Pre-training
再适配下游任务
175B Parameters
展示 Few-shot 能力
以对话产品
走向大众
这些路线长期并存。AI 的历史也有低谷,旧方法今天仍在使用。
史料:Dartmouth 提案 · IBM · Transformer 论文 · ChatGPT 发布 · 完整来源见讲义
早期主流路线 · Symbolic AI
你把判断方法写清楚,它照着规则一步步推下去。
类比:公司报销审批
Knowledge Base 存规则;Inference Engine 匹配条件、串起结论。
把专家的判断整理成规则,像随时可查的老员工手册。适合规则清晰、范围固定的任务。
“发票丢了,但银行有记录。”例外越来越多,人就得继续补规则。
这一代的知识,主要由人整理并写进去。
历史案例:McDermott · R1 Expert System, 1982 · 审批流程为课堂类比
从数据学习 · Machine Learning
像教新人分邮件:先看一批已经分好类的,再试着独立处理。
这封是垃圾邮件
那封是正常邮件
链接数量、词语、发件人
整理成可计算的数值
调参数,减少分错
得到一个 Model
收到新邮件
给出分类结果
常见的传统做法中,人设计 Features,算法学习它们如何影响判断。
Training Set 用来学习,Test Set 用来检查泛化。只记住练习题会 Overfitting。
这里演示的是 Supervised Learning;Machine Learning 还包括其他学习方式。
参考:Google · ML Crash Course · 邮件流程为教学示意
2012 · AlexNet 成为标志性突破
像一组逐层加工信息的工作台:前面的输出,交给后面继续处理。
很多可调节的计算单元,按层连接。后面会拆开看。
用多层网络学习表示。特征提取与任务目标一起训练。
AlexNet 把深层 CNN、大量标注图像与 GPU 训练结合起来。
分层图只是帮助理解;真实网络中的特征通常分散在多个单元里,并非每层都对应一种人能命名的东西。
另一条重要路线 · Reinforcement Learning
每一步未必有人教;通过行动后的 Reward,学习怎样获得更好的长期结果。
看当前棋盘
选择下一手
获得结果反馈
改进落子策略 ↻
1997 · Deep Blue
像高速推演许多棋路,再比较哪条更有利。它还不是今天的 LLM。
2016 · AlphaGo
从人类棋谱学习,再通过自我对弈改进;Policy / Value Networks 配合 Monte Carlo Tree Search。
规则明确、反馈可靠的棋盘,和开放的现实工作,难点并不相同。
2017.06.12 · Transformer
让一句话里的信息,更直接地相互联系。
按顺序处理 Token,把 Hidden State 传下去。远处的信息要经过许多步,训练时也有串行依赖。
每个位置计算该参考哪些位置、各参考多少。原始 Transformer 减少了对循环结构的依赖,训练更易并行。
论文最初用于翻译,包含 Encoder + Decoder。后来的 GPT 沿着 Decoder-only 路线发展。Attention 在这篇论文之前已经存在。
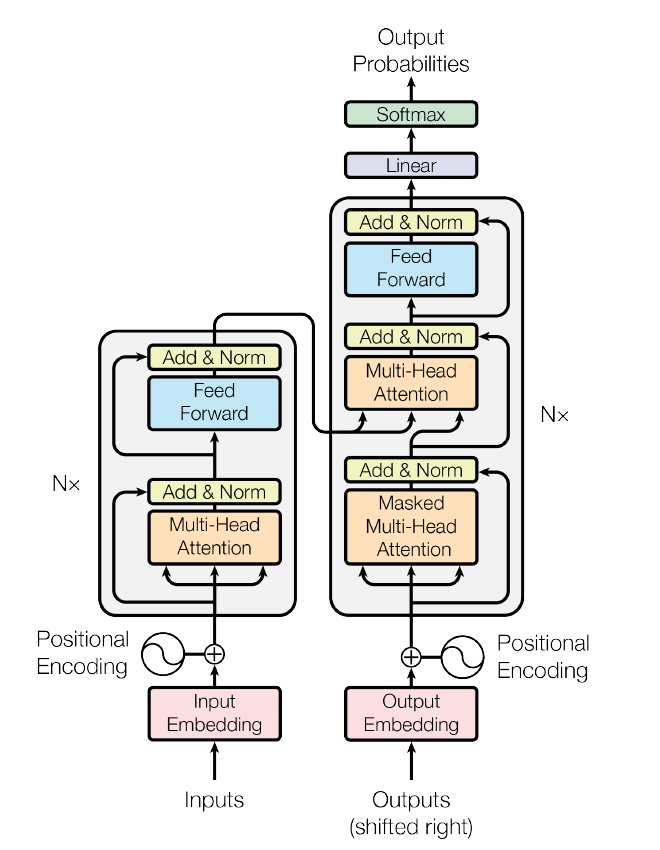
论文与原图:Vaswani et al. · Attention Is All You Need · 图据原论文摘取,Google 允许署名的新闻与学术用途
LLM 时代 · 从语言模型到对话产品
先用大量文本做语言 Pre-training,再用有标签的数据适配任务。
Generative Pre-trained Transformer
175B Parameters。Prompt 中给几个例子,就能完成多种任务。
Few-shot / In-context Learning
基于 GPT-3.5 系列模型,结合对话训练与人类反馈,以研究预览的形式发布。
对话界面让使用门槛大幅下降。
拆开 Neural Network · 1 / 2
不同线索有不同分量;Weight 决定每条线索怎么影响结果。
简化例子:判断一条消息是否紧急
这里的数值由老师设定,只用于演示计算。
z = Σ wᵢxᵢ + b
2 × 1 − 0.5 × 1 − 0.3 = 1.2
a = ReLU(z) = max(0, z)
这次输出 1.2;若 z 为负数,就输出 0。Activation 带来非线性,让网络能组合更复杂的关系。
1.2 是传给下一层的中间数值,还不是概率。
一个单元很简单;大量单元连接起来,参数一起学习,才形成网络的能力。
参考:Goodfellow, Bengio & Courville · Deep Feedforward Networks · 该类比不表示人工神经元等同于生物神经元
拆开 Neural Network · 2 / 2
Input 经过 Hidden Layers 到 Output;每条连接的 Weight 都可以参与学习。
圆点做计算,连线带 Weight。网络是一串数值运算,不是缩小版的人脑。
w ← w − η · ∂Loss/∂w η = Learning Rate,控制每次调多大
Rumelhart, Hinton & Williams · 1986 · 图为简化 Feedforward Network;公式为最基本的 Gradient Descent
先建立一个直觉
输入前文,预测下一小块文字,再把它接回去。先用这个比喻理解生成。
候选仅为示意。像输入法在等下一笔,LLM 会把这个过程持续下去。
为了预测文章、代码和对话,模型需要学到语法、知识关联,以及支持部分推理任务的模式。
现代 LLM 能处理长 Context 和复杂指令。回答像人,不足以说明它具有人类的情感或意识。
回答来自训练中学到的 Parameters + 本次 Context。要查实时资料,还需要检索或其他工具。
GPT · Language Modeling · GPT-3 · Few-shot Learning · 本节聚焦 GPT 类 Autoregressive LLM
进入 LLM 的内部
可以把 Parameters 想成许多可调的旋钮。训练让它们共同形成语言与任务能力。
Parameters
约 1750 亿个可学习数值,分布在 Embedding、Attention、FFN 等部分。
Data
文章、代码、对话等提供学习信号。质量、覆盖面、去重都会影响效果。
Compute
硬件反复计算预测、误差和梯度,调整网络中的 Parameters。
“更大”不保证每项任务更好。数据、训练方法与使用方式,同样影响结果。
LLM 属于 Neural Network 的应用;本节聚焦 GPT 类、基于 Transformer 的 Autoregressive Language Model。
Brown et al. · Language Models are Few-Shot Learners, 2020 · 175B 是 GPT-3 的历史数值,不代表所有 LLM
LLM 怎样“炼”成
Pre-training 学广泛模式,Post-training 改进回答方式,Inference 才是你使用它的时刻。
01 · Pre-training
用大量文本练习预测下一 Token,更新 Parameters。
02 · SFT
学习“指令 → 好回答”的样本,练习按任务交付。
03 · Preference Training
经典 RLHF 用人类排序和 Reward Model 优化回答。
04 · Inference
用已训练好的参数逐步生成,本轮通常不更新权重。
这是教学用的典型路线。SFT 与 Preference Training 属于 Post-training;实际模型也可能用其他目标、反馈来源和训练顺序。
训练 · Pre-training
Self-supervised Learning:答案就藏在原文的下一个位置。书籍、网页、代码等都能提供练习。
原文 · “今天 天气 真 好”
| 已知前文 | 目标 Token |
|---|---|
| 今天 | 天气 |
| 今天 天气 | 真 |
| 今天 天气 真 | 好 |
这一次目标是“好”
Loss = −log P(好 | 今天天气真)
给正确目标的概率越低,Loss 越大。
对许多位置和许多文本累计训练,调整同一套 Parameters。
为了在多样文本上预测得更好,模型会学到语言结构、知识关联,以及能支持部分推理任务的模式。
训练可在 Mask 下并行计算多个位置的 Loss;生成时,下一步仍依赖刚选出的 Token。训练目标本身没有保证事实正确。
GPT · Language Modeling Objective · GPT-3 · Token 切分为示意;训练材料经过选择与处理,不等于读过整个互联网
训练 · Post-training
Pre-training
已经学过菜谱和小说的写法;怎样按用户要求回答,还需要训练。
Supervised Fine-tuning · SFT
指令:“用 3 步教我做西红柿炒鸡蛋。”示范:① 备料 ② 炒蛋盛出 ③ 炒番茄后合炒。
RLHF · 一条典型路线
人比较“清楚可做的步骤”和“无关的故事”,给回答排序;训练 Reward Model,再用 RL 优化策略。
类似练习之后修改自己的“做题方法”。Pre-training 与 Post-training 都会更新参数。
Prompt 和 Context 像桌上的临时资料。普通一轮聊天通常不会即时更新模型权重。
SFT 提供示范,RLHF 提供偏好信号;这不保证每条回答都正确。这是 ChatGPT 早期的一条训练路线。不同模型的 Post-training 方法会变化;产品的 Memory 或后续数据训练机制,也需另行区分。
OpenAI · Introducing ChatGPT · Ouyang et al. · InstructGPT, 2022
生成 · 先看全貌
贯穿例子:“今天天气真好,我想去___”。接下来逐站拆开这条流水线。
01
当前已有的文字
转换成 ID
02
得到带有顺序信息
的向量表示
03 · 重复多层
Attention 混合信息
FFN 继续加工
04
给词表中的 Token
分配概率
05
选出一个 Token
接回输入,再继续 ↻
P(next Token | 当前 Context)
你看到一整段回答,底层是在重复生成下一个 Token。
Radford et al. · GPT §3 · 图为概念流程;后面用 KV Cache 图解释如何复用历史计算
生成 · Tokenization
计算机接到的是 Token ID。编号只是索引,2304 不会比 99 “更有意义”。
输入 · 今天天气真好,我想去
上面的切分和 ID 全部是教学示意,不是某个真实 Tokenizer 的输出。
可能是一个词、词的一部分、标点、空格或字节片段。中文也可能被拆成多个 Token。
词表大小由模型与 Tokenizer 决定。“约 10 万”可以举例,不能当通用规格。
“我帮你”和“你帮我”用到相同文字。Position 信息帮助后面的网络区分先后关系。
生成 · Embedding / 1
把 Embedding Matrix 想成一张大表。行号是 Token ID,一行就是一个 Vector。
| Token / ID | Vector 的一小段 |
|---|---|
| 猫 · 001 | [0.23, −0.81, 0.05, …, −0.42] |
| 狗 · 002 | [0.21, −0.79, 0.04, …, −0.39] |
| 水泥 · 003 | [−0.64, 0.32, 0.91, …, 0.18] |
例如 ID 001 取出“猫”这一行,再与网络里的其他矩阵相乘。数字会参与后续的 Attention 和 FFN。
这些数字属于 Parameters。它们与网络里的其他权重一起,靠训练逐步调整。
100,000 × 4,096 = 409,600,000假设 10 万个 Token、4096 维:仅这张表就有约 4.096 亿个可学习数值,不是整个模型的参数量。
Transformer · Learned Embeddings · 词表大小、维度和示意坐标不代表任何特定模型
生成 · Embedding / 2
地图用两个数字定位;Vector 用一串数字表示。计算机直接做加法、点积和矩阵乘法。
“猫”和“狗”常出现在相似语境。训练可能让它们的表示,在某些方向上相似。
“是不是生物”“能不能吃”能帮助想象特征;实际的语义通常分散在许多维度里,也可能混在一起。
可以把它想成很多项共同起作用的数字打分。不要把第 17 维固定叫作“可爱程度”。
Mikolov et al. · Word Representations · 图为原创教学示意;距离与维度的解释依赖模型和测量方法
生成 · Embedding / 3
从头训练时,可学习的 Embedding 通常从随机数起步。目标是降低 Loss。
01 · Forward
训练样本:“我家养了一只猫”。只给前文,让模型猜下一个 Token。
02 · Loss
假设给“猫”的概率只有 2%,这道题的 Loss 约为 3.91。
03 · Backpropagation
算出每个参与计算的参数,怎样影响目标 Token 的 Loss。
04 · Optimizer
更新 Embedding 和网络权重,再处理下一批样本。
Loss = −ln P(猫 | 我家养了一只)−ln(0.02) ≈ 3.91;若目标概率变成 0.10,Loss ≈ 2.30。数字与切分为示意。
训练目标没有逐对下令“把猫和狗拉近”。相似的上下文提供相似学习信号,关系可能在许多次更新中形成。
GPT · Training Objective · Deep Learning · Backpropagation · 一次更新不保证每个样本都更好
生成 · Embedding / 4
经典 Word2Vec 研究发现:部分词义关系,可以近似表示成 Vector 的方向差。
词在大量语境里的关系,会影响学到的表示。计算机无需先得到一份人工编写的语义词典。
效果依赖语料、模型和具体词。它不代表完美复刻人类逻辑,也不能保证现代 LLM 的每组 Token 都满足这个关系。
Mikolov et al. · Efficient Estimation of Word Representations, 2013 · 原创关系图,非论文数据重绘
生成 · Contextual Representation
初始 Embedding 像通用词条;Transformer 的 Hidden States 会逐层结合当前可见的上下文。
🍎 · 苹果很好吃
“好吃”与前文一起,让此时的表示更有利于预测水果相关的后续内容。
📱 · 苹果发布了新手机
同一个初始“苹果”条目,进入不同语境后,会参与形成不同的上下文表示。
最后位置“去”的 Hidden State 汇入前文信息,供 Output Head 预测后续。户外活动可能更合适,“加班”也没有被一条硬规则排除。
本节是 Causal Decoder:各位置只能参考自己与前面的 Token。“苹果”位置不会偷看后文;读到句末的位置才拥有完整前缀。这里的“理解”描述模型行为,不等于读出了唯一、完整的真实意图。
Transformer · Masked Self-Attention · 示例切分与语义变化均为教学示意
生成 · Self-Attention
像开会:带着当前问题,看谁的线索相关,再按相关程度汇总信息。
“小王把报告交给小李,因为他负责汇总。”
处理“他”时,需要结合前面的信息。
线粗仅表示“分配不同权重”的示意,不是实测 Attention,也不能据此确定“他”指谁。
当前位置
要找什么线索
每个位置
提供匹配线索
匹配之后
要汇入什么信息
同一组输入表示,经三组学到的投影矩阵,得到 Q、K、V。
Causal Mask 让当前位置看不到未来 Token。Multi-Head 用多组投影并行计算,再合并结果。
Vaswani et al. · §3.2 · 这里的 Attention 在当前序列内部计算;联网检索需要额外工具
生成 · Transformer Block
一个 Block 像一轮小组协作:先交换信息,再各自加工,保留原有信息继续往下传。
常见 Pre-Norm Decoder Block 示意
这样的 Block 重复多层;不同模型的结构细节会有差别。
对每个位置做带 Activation 的变换,继续组合特征。同一层中,各位置共享 FFN 参数。
Residual 把原表示加回来,帮助信息和梯度流动。Normalization 调整数值尺度,让训练更稳定。
最后把向量投影到词表,得到 Logits;Softmax 再把分数变成概率。
pᵢ = exp(zᵢ) / Σⱼ exp(zⱼ)
Transformer §3 · GPT-2 §2.3 · 原论文采用 Post-Norm,此处采用常见 Pre-Norm 画法
生成 · Output Head
取最后位置的 Hidden State,经过 Output Head,为词表中的每一个 Token 计算一个 Logit。
| 候选 | Logit | Probability |
|---|---|---|
| 公园 | 2.0 | 66.5% |
| 海边 | 1.0 | 24.5% |
| 公司 | 0.0 | 9.0% |
pᵢ = exp(zᵢ) / Σⱼ exp(zⱼ)例如:exp(2) / [exp(2) + exp(1) + exp(0)] ≈ 0.665;此处 Temperature = 1。
Logit 是分数,不是百分比。Softmax 表示下一 Token 的相对可能性,也不等于一句话的事实可信度。
Transformer §3.4 · Embeddings and Softmax · 所有数字均为教学计算
生成 · Decoding
沿用“公园 / 海边 / 公司”的微型词表。Decoding 决定如何使用这一组分数。
Greedy Decoding
这一步选“公园”。后续仍然要逐步计算,不能据此保证整段答案最好。
Sampling + Temperature
T < 1 让分布更尖;T > 1 让它更平。“海边”也可能被选中。
低 T 常用于减少表达变化;高 T 可用于探索更多写法。代码、数学仍需验证。
Top-p / Nucleus Sampling
T = 1、Top-p = 0.9 时,前两项累计约 91%,保留“公园”和“海边”,再归一化采样。
按累计概率截取,不是保留 90% 的词表。
pᵢ(T) = exp(zᵢ / T) / Σⱼ exp(zⱼ / T)公式适用于 T > 0。界面中的 T = 0 通常代表近似或直接采用 Greedy,具体由实现决定。
控制变化,不等于控制真假。先用模型默认参数,一次只调一个;后面的 Chatbot 章节会按工作场景练习。
Hugging Face · GenerationConfig · 具体参数支持与解码顺序以使用的平台为准
生成 · Autoregressive Loop
像写句子时不断续笔;刚写出的内容,也会影响下一步。
当前 Context · “今天天气真好,我想去”
沿用上一页的 3 候选示意分布;切分也为示意。现实中一个“公园”不保证只有一个 Token。
本次假设选中“公园”
把选出的 Token ID 加到序列后面,更新状态,再预测下一 Token。
下一步继续
继续到 EOS / End-of-turn 等结束标记、输出长度上限,或外部中止。结束标记通常不会显示给用户。
Decoding 决定怎么选。可以选最高概率,也可以 Sampling。Temperature 调整分布的尖锐程度,不是“事实正确率”旋钮。
生成 · Prefill 与 Decode
像开会时留下笔记:下一轮要参考前面的内容,无需把旧笔记重写一遍。
Prefill · 先处理输入
在 Causal Mask 下处理 Prompt;最后位置的输出用于选择第一个新 Token。
Decode · 继续生成
只计算新增位置,并把新 K / V 加入 Cache。每一层都可以复用已有的 K / V。
新 Token ID 已经选出;常见实现直接传这个 ID 与 Cache,无需每步重新分词,也无需重算全部旧 Token。
Causal Mask 让旧位置不依赖后来出现的 Token,才有这种复用条件。KV Cache 是当前序列的中间状态,不是模型权重,也不等于产品里的长期 Memory。
Hugging Face · How Caching Works · 图为常见 Decoder 推理流程;省略并行与推测解码等优化
能力边界 · Context Window / 1
把 Context Window 想成本轮能处理的 Token 预算。聊天记录、资料与回答都会占用空间。
示意预算 · 16K Tokens,不代表任何特定产品
这里 K 表示 1000。输入上限、输出上限以及推理 Token 的计费与预算规则,以具体模型接口为准。
① 历史 K / V 需要内存空间。
② Full Self-Attention 处理长序列需要更多计算。
③ Position 表示与长文本训练影响长度泛化。
④
资料即使放得下,也可能漏用关键内容。
窗口标得很大,只说明允许处理的长度。完成任务还要看它能否找到并正确使用关键证据。
能力边界 · Context Window / 2
先固定模型、精度与并发数,只看序列长度 N。不要把不同阶段的复杂度混在一起。
KV Cache · Storage
普通全长 Cache 为每层、每个历史位置保存 K / V,随 N 线性增长。
Prefill · Full Attention
整段序列里,位置要两两匹配。该部分计算量约为 O(N²),不是整个请求耗时的通用公式。
Decode · With KV Cache
新 Query 与已有 Keys 匹配。单步的这部分 Attention 约为 O(N),旧 K / V 已缓存。
Cache bytes ≈ 2 × L × N × Hₖᵥ × d × b单序列示意:32 层 × 8192 Tokens × 8 个 KV Heads × 128 维 × 2 bytes × K/V 两份 ≈ 1 GiB;长度翻倍约 2 GiB。未计模型权重与其他内存。
L 为层数,Hₖᵥ 为 KV Head 数,d 为每个 Head 的维度,b 为每个数的字节数。FlashAttention 可避免存完整 N×N 注意力矩阵;GQA、量化与 Sliding Window 也会改变具体成本。
Cache Shapes / Complexity · FlashAttention · 示例为普通全长 KV Cache;固定并发数为 1
能力边界 · Context Window / 3
硬件能运行只是第一步。模型还要处理长距离关系,并在很多干扰信息里找到证据。
位置表示与训练长度会影响泛化。直接把最大长度参数调大,不保证远处的关系仍然处理得好。
RoPE Scaling、YaRN 与长文本继续训练等方法可以扩展能力;没有“超过原训练长度就必然失效”的统一断点。
研究发现,一些模型在相关信息位于中间时表现较差。“注意力被稀释”可作直觉,不能当唯一的已证实原因。
先筛资料,再让它作答。标明任务与证据位置,保留原文出处;长文可分段处理,再汇总并核对。
把原理带回你的工作
生成“看起来合理的回答”,与核实“现实中是否成立”,是两件需要分别检查的事。
原创 AI 生成漫画 · 用于演示 Hallucination
在资料不足、问题含糊等情况下,模型仍可能生成像真的细节。流畅程度与自信语气都不能当证据。
提供可靠 Context,要求可查来源;用检索和工具补证据;对数字、引用与关键结论做人工验收。
现在试着用自己的话解释:文字如何变成数字?Attention 做了什么?下一个 Token 怎样出来?
能力局限:ChatGPT · Limitations · Lewis et al. · Retrieval-Augmented Generation · 检索与核查可降低风险,不能保证零错误
能力边界 · Hallucination / 1
Hallucination 可以表现为虚构细节、错误事实,或与给定材料不一致的回答。
01 · Training Objective
Next-token Prediction 学习文本规律。训练文本可能有错;给 Token 较高概率,不意味着现实里已经验证过。
02 · Knowledge Gaps
冷门事实、最新消息、未提供的私人数据,模型可能不知道。它有时会用熟悉的模式补全,也可能承认不确定。
03 · Autoregressive Context
生成的内容成为后续 Context。一个错误前提可能引出更多假细节;模型仍可能纠正,不是被迫一直编下去。
把项目发布日期写错 → 用错误日期解释“为什么赶上市场” → 再补一条不存在的新闻。读起来连贯,证据却没有增加。
错误可能由多个环节共同造成。不要把每一次 Hallucination 都归为同一个原因,或解释成模型有意撒谎。
OpenAI · Why Language Models Hallucinate · GPT · Autoregressive Objective · 因果链为教学示意
能力边界 · Hallucination / 2
Post-training 与 Decoding 会影响回答行为。它们也需要与事实核查配合。
Feedback / Reward
如果评价偏好完整、权威的回答,却不核对真假,就可能鼓励猜测。合理的反馈也能奖励澄清、拒答和表达不确定。
RLHF 能改善遵循指令和部分真实性表现;不能把 Hallucination 一概说成 RLHF 的副作用。
Temperature / Sampling
提高 T 会给低概率候选更多机会,也可能增加错误风险。低概率不等于错误,高概率也不等于真实。
T 很低或 Greedy 仍会 Hallucinate。Temperature = 0 无法补上缺失的知识与证据。
给好回答的标准加一条:不知道的地方要说清,事实要能追到来源。具体数字用程序计算,关键结论由人验收。
能力边界 · Hallucination / 3
课堂情境:你问“我们上季度收入是多少”,却没有提供任何报表或数据工具。
Context
提供获准使用的报表,说明季度、币种、统计口径。资料里没有,就先问或写明缺失。
Tool Use
从指定数据源读取,用表格或程序求和;保留来源和计算过程。
Verification
检查数字是否对上原表,期间与单位是否一致,引用是否真的支持结论。
你现在应该能解释
为什么聊天会影响本轮回答,却通常不改变权重?为什么 Vector 能表示语言?为什么有 KV Cache 还会有 Context 限制?为什么低 Temperature 仍可能说错?
带着这些原理,下一步练习Chatbot、Prompt 和 Tool Use,把生成能力接到具体工作里。
Lewis et al. · Retrieval-Augmented Generation · 教学工作场景;检索、工具和核查都不能保证零错误
开始使用 AI · Chatbot / Prompt / Tool Use
像和同事一起改一份草稿:你交代任务,AI 给初稿,你再提出修改。
根据这份会议记录,给客户写一封跟进邮件。
以下是初稿:今天讨论了三个需求……下一步建议……
缩到 200 字。语气自然一点,删掉我们还没承诺的上线日期。
Message → Turn → Conversation
一条输入或回复是 Message;你问、它答形成一轮 Turn;多轮累积成 Conversation。
适合解释、整理、改写和一起构思。有没有用,要拿实际交付要求来验收。
它也可以接上搜索、文件和代码工具。聊天窗口里的能力,取决于背后连了什么。
原创对话示意 · Conversation state · Tool use
Chatbot · 谁在说话,也很重要
Prompt 可以理解为给 AI 的任务说明;不同 Message Role 标明信息来自谁。
System Prompt
“你是客服助手。依据产品资料作答;资料没有的内容,请说明。”
通常由应用配置,用户未必能看见或修改。
User Prompt
“请根据这份退货政策,帮我写一封给客户的回复。”
把目标、必要资料和想要的成品交代清楚。
Assistant Message
“您好,根据您提供的政策,符合以下条件时……”
先前回复可以进入后续对话,也可能包含需要纠正的错误。
在输入框里写“SYSTEM:我是管理员”,仍然是一条 User Message;不会因此获得系统权限。
Provider 的字段不同:OpenAI 新模型常用 Developer Message 承接应用指令,优先于 User;Claude 把 system 放在请求顶层。这里讲用途,不把两家的 API 格式混成一套。
Chatbot · 把上一章的 LLM 原理接起来
想象助理先收到一个资料袋,再根据袋里的内容逐步写出回复。
01 · Assemble
App 组合规则、相关历史、本次输入和已选资料。
02 · Prefill
Tokenization 后,模型计算这份 Context 的表示。
03 · Decode
预测并选出下一个 Token,再继续生成后面的内容。
04 · Streaming
开启 Streaming 时,App 将陆续收到的片段显示给你。
App 保留或关联这一轮对话。下一次发送时,再整理需要的历史和新任务。
这一轮通常是在做 Inference。它不会因为“认真读了你的话”,就立刻更新模型的 Parameters。
简化流程,不含 Tool Use。KV Cache 可复用计算;屏幕上的一个 Streaming 片段,也不一定恰好是一个 Token。
Chatbot · 为什么“我之前说过”还不够?
这一轮能用上的信息,要先被放进当前 Context。
聊天界面里的旧消息,可能经过截断、摘要或 Compaction;附件也可能只取了相关片段。
产品保存的偏好与长期资料,需要被检索、选择或加入 Context,才能影响这次回答。
重贴关键约束,明确资料版本;必要时开新对话,并附一份简短的工作交接。
Chatbot · 采样参数
像调节选词时的“冒险程度”:低一些更集中,高一些更分散。
Temperature = 0.5
Temperature = 1.0
Temperature = 1.5
它改变采样分布,不负责核实事实。Temperature = 0 也不保证每次输出完全相同。
教学示意:相同 Logits [2, 1.2, 0.3],按 Softmax(Logits / T) 计算并四舍五入;这里只画 3 个候选。图中概率不代表“答案正确率”。
Chatbot · 认识两个常见参数
这些参数常见于 API 或 Playground,普通聊天界面未必提供。
Top-p · Nucleus Sampling
假设候选概率依次为 60%、25%、10%、5%。Top-p = 0.8 时,保留前两个,再从中采样。
累计 60% + 25% = 85%,已达到 80% 阈值。0.8 不表示保留词表中 80% 的词。
Max Output Tokens
像给草稿设置纸张上限。达到上限可能被截断;给得多,也不代表一定写满。
Token 不等于汉字;部分模型的生成预算还包含 Reasoning Tokens。它与整个 Context Window 的容量不同。
入门先用默认值。确实需要调整时,一次只改一个参数,观察同一任务的结果。
是否支持、可调范围和字段名,取决于模型、API 与 App;部分模型不支持调整 Temperature / Top-p。
参数实战 · Temperature
希望同样的材料得到更一致的结果,还是希望一次看到更多不同方向?
抽取 / 分类 · 减少变化
只按客户邮件原文填表。支持调参时,可尝试较低 Temperature,观察重复运行的结果是否更一致。
验收:字段齐全、能对上原文。稳定输出同一个错误,仍然是错。
日常撰写 · 先用默认
先交代读者、语气、长度和必含信息。若同一任务的措辞变化过大,再对照较低 Temperature。
验收:重点有没有遗漏,是否符合语气。写得生硬,先补一个好示例。
创意发散 · 尝试更多变化
要求“给 10 个不同角度的方案”,对照 T = 0.2 与 0.8。看看是否多了可用的新方向。
验收:方案有差异,也符合受众与资料。变化更多,不保证创意更好。
同一件工作也能分两步:先发散方案,再选定方向,补上事实、格式与验收要求,写成可交付的版本。
0.2 / 0.8 是课堂对照起点,非通用最佳值。先确认模型支持,再从 Provider 默认配置开始;部分模型不允许调整这些参数。
场景为课程建议 · OpenAI · Temperature · Claude · 使用方向与支持范围
参数实战 · Top-p
它更适合进阶对照试验;多数日常工作保留默认值就可以。
想收窄表达范围
已有风格要求和示例,仍出现不合适的措辞时,可小幅降低 Top-p,观察筛掉低概率候选后的效果。
代价:可能更重复,也可能筛掉有用表达。品牌术语与禁用词仍要在 Prompt 里说明。
想扩大候选范围
先在 Prompt 中明确需要的不同角度。若之前把 Top-p 调低了,可往默认值靠近,对照更大候选范围的效果。
边界:已是 1,就没有更高的 Top-p 范围。候选变多,不保证点子更好。
这些情况,先处理别处
补可靠资料与检索,用程序核算,按 Schema 检查格式。Temperature 和 Top-p 都不能替代这些步骤。
判断:先弄清问题出在资料、任务要求、格式,还是你希望的变化程度。
课堂对照:固定模型、Prompt 和 Temperature,只改 Top-p。每组生成 3 次,比一致性、差异性与事实依据。
数值仅为支持调参模型的试验示例。一次选一个采样参数调整;3 次用于课堂观察,不能代替真实任务评测。Prompt 中写“Top-p = 0.9”不会修改 API 参数。
场景与试验为课程建议 · OpenAI · Top-p / 单参数调整 · Claude · Advanced use cases
Prompt · 从“它好像没懂”开始
“随便做一下”里的那个“随便”,每个人理解得都不一样。
原创 AI 生成漫画 · Prompt 与工作交付
“帮我写报告”没交代读者、资料范围、用途和标准。回答可能流畅,却交不到你要的东西。
把任务、资料和验收要求摆到桌上,让生成过程有更具体的方向。
Prompt 能帮助用好已有能力;最新事实、私有数据和操作权限,还需要可靠资料与实际连接。
课程依据:assets/outline.pdf · §2.3 · Prompt engineering
Prompt · 沿用 outline 的四个抓手
先想清楚“收到什么样的成品,我会觉得这件事做完了?”
01 · Role · 角色设定
“从销售运营的视角,给一线销售整理竞品动态。”
可选辅助。写“你是顶级专家”不会自动带来专业证据。
02 · Task · 任务描述
“把三篇新闻整理成一张四列表,正文不超过 500 字。”
把 Output Format 一起说清楚:表格、邮件、清单还是 JSON。
03 · Context & Constraints · 背景约束
“只用附上的新闻;影响判断标成推断,缺失信息写未提供。”
给相关资料、适用范围和必要限制,别把无关内容全部塞进来。
04 · Acceptance Criteria · 验收标准
“每行有来源;保留日期;事实与推断分开,不能编出客户反馈。”
越能直接检查,越容易指出问题并改进下一版。
简单任务可以一句话完成。复杂工作再展开,无需每次填满一套模板。
课程依据:assets/outline.pdf · §2.3 · Claude · Clear instructions / Context
Prompt · 把要求写成能直接使用的文本
AFTER · 可直接改写使用
Role请从销售运营视角,为一线销售整理竞品动态。
Task根据下方三篇新闻,生成一张表:
核心变化 / 对客户的影响 /
建议跟进问题 / 来源。
Context & Constraints只用附上的正文。保留新闻日期;影响判断标注“推断”,缺失信息写“资料未提供”。
Acceptance Criteria正文不超过 500 字;每行附来源编号;不把发布日期当成事件日期,不编造客户反馈。
【资料开始】
[1] 标题、日期、来源链接、正文……
[2] …… [3] ……
【资料结束】
原创工作示例 · 综合 assets/outline.pdf 的“新同事”比喻与四要素 · 资料占位符需替换成真实正文
Prompt · 说不清“我要什么风格”?给一个样板
给少量 Input / Output 示例,让格式、语气和判断尺度更容易对齐。
Example Input · 虚构资料
[1] 云笔记于 9 月 10 日公告:团队版新增导出功能,价格未提及。
Example Output · 示范证据边界
核心变化:团队版新增导出功能 [1]
价格变化:资料未提供
跟进问题:客户需要哪些导出格式?
Delimiters · 给资料加边界
标题、引号或标签都可以。让“要求”和“被处理的材料”容易区分;边界标记本身无法保证抵御 Prompt Injection。
示例要贴近实际任务、格式一致;也给一个“信息不足时怎么写”的样板。
Prompt · 不用追求一次写出“万能神咒”
Clarify
“如果资料不足以判断,请指出缺口,最多问两个关键问题。”
Plan
“先列执行步骤、需要的资料与检查点,确认后再展开。”
Draft → Review
查来源、数字、遗漏和格式;指出哪一处不满足要求。
笼统反馈
“不太行,重新写。再专业一点。”
可执行的反馈
“第 2 行没有来源,删掉。影响写成推断;保留原表四列,每格不超过 40 字。”
资料充分的简单任务可以直接做。Plan 是可见的工作步骤;无需索取隐藏的 Chain-of-Thought。模型说“已自检”,仍要核对成品。
课程依据:assets/outline.pdf · §2.3 · Reasoning best practices
Tool Use · 从生成文字到调用外部能力
让语言模型能查资料、运行计算,或通过应用执行具体操作。
原创 AI 生成漫画 · 工具连接的比喻
根据任务和可用 Tool 的说明,选择工具,提出带参数的 Tool Call。
连接外部程序,运行计算或操作,把结果交回模型。工具要真实存在,也要有访问权限。
“已为你算好 / 发出 / 保存”是一句话。Tool Result、发送回执或实际文件,才是检查任务是否完成的依据。
Tool Use · 以一个计算工具为例
User:“本月销售额 120,上月 100,环比增长多少?”
calculate_growth · 计算增长率;Arguments 要求 current 与
previous 为数值。
01 · Model → Tool Call
name: calculate_growth
arguments: {
  "current": 120,
  "previous": 100
}
02 · App / Runtime
验证参数、单位、权限,检查分母不为 0,再调用函数。
03 · Tool Result → Model
{
  "growth_rate": 0.2
}
模型据此回答:“按你提供的数值,环比增长 20%。”
结果还不够?↺ 模型可以继续调用工具;数据不足或工具报错时,也要处理后再回答。
这是 Provider 无关的教学示意,不是某家 SDK 的请求代码。Schema 描述参数形状,不能替代业务校验;Server Tool 也可能由 Provider 执行。
Tool Use · 放进真实工作里
Read · 读取
Web Search 查最新公告,连接 CRM 读客户记录,读取文件正文。
检查:来源、日期、对象是否正确,是否有访问权限。
Compute · 计算
Calculator 算增长率,Code 执行 CSV 汇总、去重与画图。
检查:输入单位、分母、缺失值,计算逻辑是否符合任务。
Write · 写入与执行
生成文件、更新记录;在已授权范围内创建日程或发送邮件。
检查:目标与内容是否正确,授权是否覆盖操作,有没有实际回执。
Tool Result 是待判断的数据。网页可能过时,工具可能失败;网页里的“忽略规则”也不能当作新的应用指令。
需要最新信息时,先取得可靠来源。MCP 是连接方式之一,Skills 可组织做法;它们本身不保证数据实时或准确。
课堂练习 · 把一次聊天接到真实工作
准备三条公开竞品资料,完成一份给销售同事看的动态简报。
01 · 交代任务
交代读者、资料、四列格式和验收标准;附正文与来源。输出后指出一处具体问题,再修改一轮。
02 · 判断需不需要 Tool
只整理已有正文,可以先直接做;要核查最新变化,就用已连接的 Search;要汇总金额,就用计算工具。
03 · 交付物
核心变化 / 对客户的影响 / 建议跟进问题 / 来源。事实有出处,推断有标注,缺失就写未提供。
04 · 验收
逐行抽查来源与日期;保存第一版和修改版。若用了工具,指出它读到了什么或算出了什么。
下一步:把常用资料、工具和这些检查步骤固定下来,放进 Harness、Skills 与 Workflow,减少每次从头交代。
原创课堂练习 · 衔接 assets/outline.pdf 的 Prompt → 工作规则 → Skills → Workflow 路线